AI代理的猛禽定律:为什么每一代模型都会吃掉上一代的Harness
在《从硅片到交响乐》中,我论证过多代理软件模式正在向下沉淀进硅片硬件。而在那之前,一个更快的周期会先冲击你的技术栈:每一代前沿模型,都会吃掉你为上一代模型搭建的Harness。
在《从硅片到交响乐》里,我拆解过多代理系统的空间解剖结构。内存管理、依赖解析、状态一致性、故障恢复与资源扩缩这五条协同不变量,迫使AI代理框架、交响乐团与CPU最终收敛到了完全一致的架构。那篇文章的结尾给出了一个硬件预测:随着NVIDIA的BlueField-4 DPU、NVLink 6以及微软Maia 200 ASIC陆续落地,今天用Python编写的编排原语将在两到三年内下沉固化进硅片。
那个预测在时间轴上留下了一个更快、更让一线团队难受的工程问题。远在定制芯片吸收你的编排器之前,每六个月发布一次的前沿大模型,就会先吞掉你应用栈里的又一层代码。
2026年底,随便走进一家做生产级AI的工程团队,你都能感受到这种剧烈的撕裂感。一面是Harness工程(代理外围控制层工程)已经演变成一门独立学科,仅2026年一年GitHub上就冒出了21,500个新的代理Harness仓库;另一面是那些真正跑严格评测的团队正在成批删掉数万行自研脚手架,而且代码删掉当天,手里的代理就变得更快、更便宜、准确率更高。
如果你也曾花整整三周写好一套校验循环、一个带20个工具的动作菜单,或者一套多阶段冲刺执行器,结果新模型一发布,这些心血瞬间变成拖慢系统的累赘,那你就迎头撞上了一条系统工程的结构性定律。火箭推进工程师给这种累赘起过一个专门的名字,还拍下了一张照片,清楚展示了它们最终去了哪儿。
猛禽发动机照片里藏着的数字
你肯定见过SpaceX猛禽1代(Raptor 1)、猛禽2代(Raptor 2)和猛禽3代(Raptor 3)并排站在一起的那张著名合照。猛禽1代看着就像管材仓库里刚炸过一场,机身外密密麻麻缠满了盘管、螺栓法兰和几十个外置传感器;猛禽2代把管线收紧了不少;到了猛禽3代,整台机器宛如一根浇铸成型的光滑金属柱,外壳上几乎干干净净。
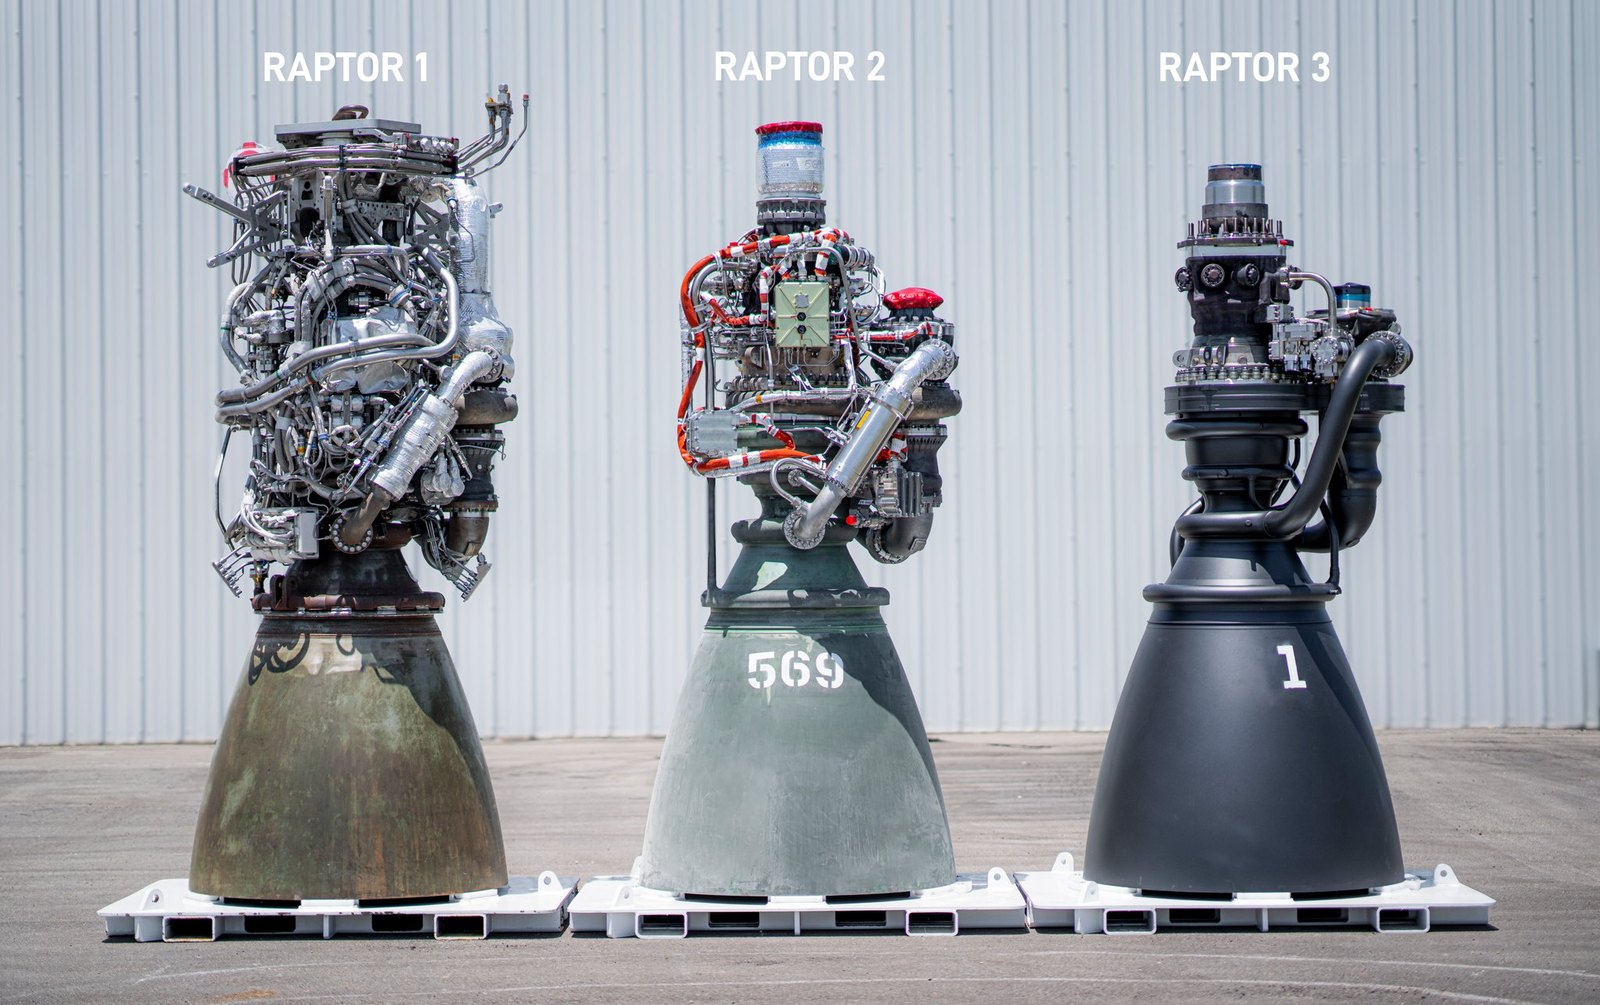
并排展示的SpaceX海平面版猛禽1代、猛禽2代与猛禽3代发动机,直观呈现了五年间外部管路与传感器被逐步吸收进本体的全过程(图片来源:SpaceX)。
外行看热闹时,很容易误判这三代发动机之间真正变化的东西。正如《Construction Physics》分析师Brian Potter在2026年9月的深度拆解中指出的那样,从第1代到第3代,核心推进架构始终保持恒定。三代发动机跑的全是同一套全流量分级燃烧(FFSC)循环,以大约3.6:1的氧燃比燃烧过冷液态甲烷与液氧,搭配双涡轮泵与再生冷却室壁。
真正脱胎换骨的地方,是原本靠螺栓死死挂在发动机外壳上的那堆外围硬件。
2024年8月SpaceX公布猛禽3代海平面参数对比表时,媒体头条几乎全盯着推力从185吨力(tf)跃升到280吨力。其实最关键的一行数据就印在发动机干重正下方:发动机本体加箭体侧管路与附属硬件质量。Elon Musk把发动机干重与总装机质量之间的差值称为诱导质量(induced mass),即由发动机设计决定、却不得不安装在发动机本体之外的配套质量。把三代发动机的总装机质量减去本体干重,你就精准分离出了AI代理Harness在物理世界里的等价物。
| 海平面指标 | 猛禽1代 (2019-21) | 猛禽2代 (2022-25) | 猛禽3代 (2026) |
|---|---|---|---|
| 海平面推力 | 185 tf | 230 tf | 250 tf 飞行值(280 tf 试车台标称值) |
| 燃烧室压力 | ~250-253 bar | ~300 bar | ~330 bar(峰值 350 bar) |
| 发动机本体干重 | 2,080 kg | 1,630 kg | 1,525 kg |
| 外部硬件("Harness") | 1,550 kg (42.7%) | 1,245 kg (43.3%) | 195 kg (11.3%) |
| 总装机质量 | 3,630 kg | 2,875 kg | 1,720 kg |
| 装机系统推重比 | 51.0 | 80.0 | 145.4 飞行值(162.8 试车台标称值) |
(推进剂核算说明:SpaceX官方表格列出的350秒是海平面喷管在真空环境下的比冲;大气海平面实际比冲在猛禽1代和3代上约为330秒,猛禽2代约为327秒。这里特意把2026年星舰V3飞行器上250吨力的实际飞行额定值与280吨力的试车台极限值区分开,免得重蹈AI排行榜上常见的跑分注水覆辙。)
做一道简单的减法就清楚了。从猛禽1代到猛禽3代,SpaceX从发动机本体上削掉了555公斤(-26.7%),同时每台发动机砍掉了1,355公斤的箭体侧外围硬件(-87.4%)。整个项目减掉的总重量里,超过70%来自拆掉外部脚手架。
单看猛禽2代到猛禽3代的跨越,这个比例还要惊人。核心发动机干重只降了105公斤(从1,630公斤降到1,525公斤),而外部硬件直接砍掉了1,050公斤(从1,245公斤骤降到195公斤)。猛禽3代相比猛禽2代的质量优势,有90.9%来自对周边脚手架的内部吸收。 放到超重型助推器(Super Heavy)的33台并联发动机上,砍掉不锈钢隔热罩、二氧化碳灭火硬件和次级分配管路,就比猛禽2代足足减掉了34.65公吨的诱导质量,比猛禽1代减掉了44.72公吨。
SpaceX靠五个扎实的工程步骤换来了这次大删减。猛禽1代升空时浑身贴满外置温度与压力传感器,方便工程师摸清未知的热力学与声学边界;等工作包线测透之后,SpaceX拆掉了绝大多数传感器,把保留下来的少数传感器埋进了内部热防护层。猛禽2代淘汰了主燃烧室电火花点火器(因为高温富燃与富氧预燃室燃气一接触就会自燃),同时取消了浪费性能的喉部液膜冷却;工程师把零散阀门整合进一体化阀板,集中了控制器,并用焊接接头取代了容易泄漏的螺栓法兰。到了猛禽3代,原本缠绕在外壳上的次级管路直接走进了由定制金属3D打印成型的金属壁内部,配合覆盖裸露表面的再生冷却设计。外壳上不再有任何脆弱的裸露管线后,猛禽3代干脆彻底取消了单机隔热罩和二氧化碳灭火系统,并用单根氮气起旋脐带管取代了原本的氦气管路。
有两条航天工程约束,让这个类比格外扎实。
第一,你没法跳过猛禽1代直接造3代。2026年9月16日,在回应外界拿猛禽3代与天兵科技「天火二十一号(Tianhuo-21)」甲烷发动机作对比时,Musk专门警告航天初创公司千万别直接照抄3代的极简外壳:
"我不建议任何新公司一上来就尝试造猛禽3代。它外表看着极简(这是为了在不装隔热罩的情况下扛住极端高温),但内部几何结构极其复杂,必须依靠深度魔改的金属3D打印工艺才能造出来。"
猛禽1代外面那团意大利面式的管线,恰恰是造出猛禽3代所必需的测量台架。裸露的传感器和螺栓法兰,让工程师能在试车台上直接观测故障模式,并在热试车受损后拧开螺栓拆换组件。
第二,复杂度向内迁移之后,会以「可观测性折损」的形式给你寄来账单。焊死法兰、把流道打印进金属内壁,确实大幅拉高了装机推重比,代价则是牺牲了部件级现场维修能力:技师只能整机替换或者直接动刀切金属,再也没法拧开几个螺栓换掉单根歧管;传感器数量锐减,也意味着对内部运行状态的观测窗口变得更窄。
这就是猛禽定律(Raptor Law):每一代核心引擎都会把上一代必须在外部挂载的承重脚手架内化吸收,大幅压缩诱导开销,同时让渡底层可观测性,并将Harness的边界向外推向一道全新的、不可再压缩的前沿。
AI代理Harness被吸收的六轮浪潮 (2023-2026)
软件工程师给最外层起名字的时间相当晚。行业术语一路演进:2023年叫提示词工程(Prompt Engineering),2025年叫上下文工程(Context Engineering),到2026年2月正式定名为Harness工程(Harness Engineering)。2026年2月5日,Mitchell Hashimoto在他的AI实践笔记里给这套做法下了定义:"每当你发现代理犯了一个错,你就花时间设计一套工程方案,确保代理永远不再犯同一个错。" 六天后,OpenAI的Ryan Lopopolo发布了Codex团队的一线实战报告,让 Agent = Model + Harness 这个公式火遍全行业。
跟猛禽发动机的燃烧循环一样,从2023年到2026年底,Transformer的底层架构始终清晰可辨,而外围的六层脚手架已经陆续沉淀进了神经网络权重和原生运行时。
| 技术域 | 第N代Harness | 第N+1代核心 | 实测变化 |
|---|---|---|---|
| 1. 结构化I/O | 正则解析器、重试循环、JSON提示词模板 | 受限解码 + Schema训练权重 | 复杂Schema遵循率从 <40%(gpt-4-0613)升至 100%(gpt-4o) |
| 2. 推理能力 | 外置CoT/ToT封装器、过程奖励模型(PRM)、MCTS搜索 | 结果导向RLVR + 原生测试时推理 | DeepSeek-R1-Zero在AIME 2024上从15.6%跃升至71.0%;PRM与MCTS退场 |
| 3. 代码检索 | 分块启发式规则、向量嵌入、本地向量数据库 | 代理主动搜索(glob、ripgrep)+ 仓库映射图 | Claude Code彻底砍掉向量库实现零陈旧度(Cursor实测混合检索仍有+12.5%增益) |
| 4. 工具接口 | 定制ACI界面、17-29项动作菜单、前置全量MCP Schema | 极简bash/Python REPL + 原生底层协议(CDP) | Browser Use 1.0得分提升14-33分且成本降低2.7-5.2倍;MCP代码执行省下98.7%词元 |
| 5. 长程执行 | 强制会话重置、按功能拆分的冲刺包装器 | 原生跨长程连贯性 + SDK上下文压缩 | Anthropic先后砍掉会话重置(Opus 4.5)与冲刺拆分(Opus 4.6),构建成本降37.6% |
| 6. 代理记忆 | 提示词硬引导、僵化的仅记录失败日志规则 | 自主闭环记忆校验机制 | Opus 5/5.5在CL-Bench 1.0原生跑出0.828-0.838;硬编码规则反倒拉低0.234 |
下面这三条真实的工程演进弧线,直观展示了昨天还不可或缺的封装层,是怎样在转眼间变成系统阻力的。
从普林斯顿SWE-agent到 mini-SWE-agent
2024年5月,普林斯顿大学的SWE-agent论文证明,GPT-4 Turbo直接扔进原生Linux shell里几乎寸步难行。研究团队在模型外层套了一套定制的代理计算机交互界面(ACI,包含100行窗口化文件查看器、按行定位编辑器以及带语法检查的自动保存),把SWE-bench完整解决率从3.8%拉升到了12.5%,在消融实验中比原生shell基线高出10.7个百分点。
不到两年后,同一个普林斯顿团队发布了 mini-SWE-agent:总共只有大约100行Python代码,在扁平的线性消息历史上直接调用无状态的 subprocess.run 执行bash命令。在2026年2月的SWE-bench Verified纯bash排行榜上,这个百行循环搭配Claude 4.5 Opus跑出了76.8%(单任务成本0.75美元),搭配GPT-5.2跑出72.8%;在2026年9月的跨Harness横向评测中也拿下了75.5%,追平甚至反超了更厚重的原生脚手架。2024年的定制ACI帮GPT-4顺利点火离地,而后训练模型一旦原生掌握了标准Unix shell,那套外挂就彻底成了冗余包袱。
Vercel的 d0 与 Browser Use 1.0
2025年12月,Vercel工程师Andrew Qu把内部Text-to-SQL代理 d0 在Claude Opus 4.5上的工具链做了一次外科手术式精简,将17个专用工具(GetEntityJoins、LoadCatalog、JoinPathFinder、SyntaxValidator等)直接砍到只剩两个原语:针对Cube语义文件目录的沙盒bash,外加一个 ExecuteSQL。他们公开的内部评测只涵盖5条查询,样本量不大,解读时应当留一份审慎;即便如此,平均执行耗时直接缩短了3.5倍(从274.8秒降至77.4秒),词元消耗下降37%,通过率从4/5升至5/5。Qu在复盘报告里用两句话精准概括了这场从猛禽2代到3代的跃迁:
"我们过去一直在用条条框框限制推理,因为我们不敢相信模型自己会推理。到了Opus 4.5,那些限制本身反而成了负资产。"
Browser Use在规模大得多的生产代码库上撞见了同一堵墙。团队花了两年时间不断为网页边界情况堆砌专用动作,峰值时攒出了29个动作和67,599行Python代码。联合创始人Gregor Zunic随后做了一个50分钟的实验,只向模型暴露一个持久化Python REPL和原生Chrome DevTools协议(CDP,cdp())接口。执行轨迹显示,模型直接无视了所有带索引的DOM辅助函数,自己动手写起了定制JavaScript选择器和原生CDP指令。
2026年11月10日,Browser Use 1.0一口气删掉了横跨554个文件的136,905行代码,把24个浏览器动作彻底收敛为一个Python REPL工具加两个完成态方法。在BU Bench v2.1锁定的180个评测任务上,受测模型得分上涨了14到33分,推理成本降低了2.7到5.2倍,甚至在没人写过预设逻辑的场景下自己即兴发挥出了恢复流程(面对卡死的交易所页面主动调用 Page.stopLoading 和 Network.setBlockedURLs,顺藤摸瓜找到JSONP接口,在3.5分钟内拉回4,720行数据)。同样值得玩味的是唯一的例外:在页面脚本缺乏底层浏览器访问权限的场景下,专用验证码求解器原语依然以6战6胜完胜纯手写代码的3战0胜。Zunic由此总结出的设计准则,与SpaceX删减零件的过滤标准如出一辙:只有当模型读完一遍源码依然无法自己重写某个辅助函数时,才保留它;只有当代理确实缺少底层系统原语时,才为它单独造工具。
外部管路如何编译进模型权重
外置Harness之所以能一步步融进下一代模型,靠的是一套明确的后训练机制。正如Philipp Schmid在2026年1月总结的那句话:"Harness本身就是数据集。" 每一代模型外挂的脚手架,都会直接变成训练下一代模型的可验证奖励强化学习(RLVR)训练场。
2025至2026年间公开发表的训练流水线完整记录了这一闭环的每一步。Meta FAIR的SWE-RL论文利用GitHub合并请求的演进历史配合规则奖励训练Llama-3.3-70B,在SWE-bench Verified上拿下了41.0%。Search-R1研究把实时搜索引擎直接放进PPO与GRPO采样轨迹,并对检索回来的文档词元做损失掩码,让梯度严格针对模型自身的查询构造与推理过程做更新,使Qwen2.5-7B相比传统RAG基线提升了26%到41%。阿里巴巴在20,000个并行容器化环境上扩展长程代理强化学习以训练Qwen3-Coder;到了2026年2月,总参数80B、每词元仅激活3B参数的混合专家模型Qwen3-Coder-Next在SWE-bench Verified上达到70.6%至71.3%,在SWE-bench Pro上达到42.7%。月之暗面的Kimi K2技术报告从GitHub采集了超过3,000个真实MCP工具,并在模拟用户交互轨迹中合成了20,000多个额外工具。ICLR 2026的一项研究还证明,经过异步沙盒强化学习训练的3B参数Qwen2.5模型,在12项MLE-Bench任务中的8项上,击败了挂载多日运行AIDE脚手架的Claude 3.5 Sonnet、Llama 3.1 405B与GPT-4o。
这套训练闭环,就是用梯度下降重写了一遍SpaceX的麦格雷戈(McGregor)试车台。工程师先给第N代模型套上显式的外部Harness来捕获可验证的执行轨迹,再拿这些真实轨迹去优化第N+1代模型,直到外部Python脚手架被彻底编译进模型内部的权重几何结构里。
实证悖论与未经度量的Harness腐化
光看前面这些吸收案例,你很容易变成一个「苦涩的教训(The Bitter Lesson)」原教旨主义者。Rich Sutton在2019年提出,善用算力扩展的通用方法终将稳定击败人工编写的领域规则;2026年6月,Google DeepMind的Logan Kilpatrick给这个观点补上了2026版注脚(《为什么模型会吃掉Harness》),估算通用代理脚手架的保质期只有12个月。
2026年9月发表的两项独立学术评测证实,通用编程模型确实正在反超专用领域Harness。加州大学伯克利分校与斯坦福大学联合发布的《当模型吃掉技术栈会发生什么?》,将通用Codex代理(从 o3 到 GPT-5.6 Sol)与人工精调的SQL及数据分析脚手架(TAG-Bench上的 Agentar-Scale-SQL 与DAB基准上的多代理框架 DeepEye)做了正面对决。底座用 o3 时,专用数据脚手架胜出;底座换成 GPT-5.6 Sol 后,通用编程代理全面反超,在DAB上暴涨超过35个百分点,输出词元效率翻倍,平均每条查询的交互轮数直接砍掉了74.1%(从23.2轮降至6.0轮)。几周后,洛桑联邦理工学院(EPFL)与苹果公司的研究团队在同等时间与GPU预算下,测试了30个MLE-bench任务上的17组Harness与基座组合,以及40个NatureBench任务上的6组组合,结果发现一个只配了文件读取、文件写入和bash三个基础工具的极简单会话代理(Malena),追平甚至击败了所有专为机器学习工程定制的复杂脚手架。
不过,在你凭着这两篇论文动手删光自家代码库之前,先看看另一组对照实验:如果把模型权重严格锁死,只改变外围环境,会发生什么?
2026年2月,LangChain在Terminal-Bench 2.0上把底层模型固定为 gpt-5.2-codex,仅靠四项针对性中间件改造,就把 deepagents-cli 的得分从52.8%拉升到了66.5%(暴涨13.7个百分点,排名从前30开外直接冲进前5):启动时自动探测目录与二进制工具、完成前强制核对验证清单、重复编辑死循环熔断器,以及一套「推理三明治」策略(规划阶段开 xhigh、编码实现阶段切回 high、最终验证再开 xhigh;此前全程死开 xhigh 因为频繁超时只拿到53.9%)。
同一个月,OpenAI的Codex一线实战报告记录了3名工程师(后来扩到7人)如何在零手写代码的前提下,合并1,500个PR、交付大约100万行生产代码。他们的核心杠杆全在确定性的环境工程上:把 AGENTS.md 精简为大约100行的 docs/ 路由索引,通过报错信息自带修复指引的定制Linter强制执行严格的单向依赖图(Types -> Config -> Repo -> Service -> Runtime -> UI),并为每个独立工作树(worktree)自动拉起专属的Chrome DevTools与可观测性栈。
Scale AI在2026年发布的SWE-bench Pro审计报告,进一步量化了各大实验室之间的真实水位差。公开SWE-bench Verified榜单上100个成绩里有99个由厂商自报;OpenAI在对未通过任务做抽检时发现59.4%存在缺陷测试或补丁背题现象,随后于2026年2月正式停用了Verified基准。同样锁死Gemini 3.1 Pro的模型权重,成绩从Verified榜单上的80.6%,掉到厂商自配Pro脚手架上的54.2%,再掉到Scale标准化SEAL Pro Harness上的46.1%。而在Scale涵盖276个任务的私有商业代码库评测集上,所有受测前沿模型的得分统统低于50%(Claude Opus 4.6思考模式为47.1%,GPT-5.4 xHigh为43.4%)。
就连Google DeepMind那期播客的核心论点,都带着一个再明显不过的产品注脚:一边警告创业公司「模型会吃掉Harness」,Google自己却在紧锣密鼓地打造横跨IDE、CLI、SDK和浏览器界面的 Antigravity Harness。正如一线实践者Jihoon Jeong一针见血的点评:"翻译成大白话,所谓『模型吃掉Harness』真正的意思是:我们家的Harness要吃掉你们家的了。"
一边是删掉十万行代码性能暴涨,另一边是改几层中间件提分14到20个点,把这两组看似矛盾的现象严丝合缝统一起来的,是2026年四项实证审计共同测出来的第三种现象:未经度量的Harness腐化(unmeasured harness rot)。
2026年7月,加拿大女王大学(Queen's University)的研究人员固定底层大模型不变,在分层抽样的SWE-bench任务上连续测试了Qwen Code CLI的35个迭代版本:单任务词元消耗膨胀了大约70%(从约39.1万涨到约66.8万词元),而任务解决率在统计意义上毫无提升。2026年10月,论文《藏在明面上的开销(Hidden in Plain Sight)》抓包分析了Claude Code、Codex、Gemini CLI、OpenCode与Qwen Code稳定版的1,886次首轮API请求载荷,发现一条21个字符的用户输入只占整个请求体积的0.02%到0.07%,隐藏的Harness系统指令与工具Schema却吞掉了高达124,873个字符(仅工具定义一项就占掉Claude Code首轮载荷的77.4%,占掉Qwen Code的72.3%)。
与此同时,Marmelab在2026年9月对246个开源编程Harness的审计显示,60%的可测试仓库既无单元测试也无评测集(同时对两者做版本管理的仅占7%),391个受检仓库里只有12个提交过哪怕一条 deny 拦截规则;苏黎世联邦理工学院(ETH Zurich)跨越138项任务的实测也表明,自动生成的上下文文件反而拉低了任务完成率,同时把推理成本推高了20%以上。Manus团队在六个月内把生产Harness重构了五遍,并在遥测数据揪出 todo.md 循环白白烧掉约30%会话词元后,果断砍掉了这个机制。
长期不修剪的提示词规则和冗余的工具封装,就像硬留在猛禽3代箭体上的猛禽1代螺栓法兰。核心引擎早就跨过了需要它们搀扶的阶段,留着它们只会白烧上下文预算、掩盖真实的故障归因,还会把模型的原生推理手脚捆死。
不可压缩的那195公斤
不妨再回头看一眼SpaceX的参数表。猛禽3代把箭体侧外部硬件从1,550公斤一路砍到195公斤,然后就停住了。哪怕是一体化金属3D打印出来的火箭发动机,依然离不开推进剂贮箱、推力传力座(thrust puck)、飞行终止系统、发射台底座以及多机协同飞控软件。冶金工艺再强,也不可能把整枚火箭的箭体边界吞进发动机肚子里。
生产级AI系统里,同样存在着与这195公斤严格对应的硬边界。
在OSWorld 2.0基准上,你能直接用数字看到这道边界。在原版OSWorld-Verified评测集(约30步、两分钟左右的桌面短任务)上,2026年中期的AI代理已经跑出83.4%至90.2%的高分,大幅甩开72.36%的人类基线。可当OSWorld 2.0扩展到108个跨应用长程专业工作流(平均超过250步、横跨2.44个应用程序,人类完成中位耗时1.6小时)时,论文最高分记录(Claude Opus 4.8最大思考模式,单次尝试成本约72.40美元,折合每个成功工作流约350美元)的严格二元完成率直接跌到了20.6%;即便到了2026年底的最新前沿模型,也依然卡在41.7%至48.7%之间。单步可靠性的指数级衰减解释了这个断崖:就算单步准确率高达99.0%,0.99³⁰ = 74.0%,而到了250步时,0.99²⁵⁰ = 8.1%。
OSWorld 2.0的作者团队指出,代理极少栽在点错UI按钮或写不出短脚本这种基本功上。真正的死因是长程跑偏丢掉约束、漏看任务中途的状态变化、遇到歧义瞎猜而不主动追问,以及跳过最终结果校验。
具体来说,有四层Harness在结构上永远无法塞进基础模型的静态权重里。
1. 可变本地上下文与生命周期交叉点
预训练和RLVR只能把公开数据分布冻结成静态权重,而你公司内部的数据库Schema、定价规则与微服务拓扑每个星期都在变。在加州大学伯克利分校与斯坦福大学的数据代理误差拆解中,GPT-5.6 Sol 剩余错误的60%以上源于本地业务语义定义、库表映射偏差和实体消歧,模型推理本身很少出岔子。仅仅在输入前挂载经过人工整理的持久化语义上下文(Persistent Semantic Context),就在42个保留DAB测试任务上把准确率直接拉高了19个百分点。Vercel在复盘 d0 时也点明了完全相同的前提条件:之所以敢放心删掉15个专用工具,唯一的前提是团队维护的Cube YAML语义定义足够干净;如果直接让模型裸读毫无文档的脏表,只会更快地生成错误的SQL。
Letta团队在2026年6月的分析报告(《迈向会持续学习的代理》)中,给这道鸿沟架上了一座经济学时钟:生命周期交叉点(Lifespan Crossover)。当前自主代理可胜任的任务时长大约每五到七个月翻一番,而前沿模型的迭代发布间隔还在持续压缩,这意味着单个模型检查点往往在部署周期半途就已经过时。模型权重按季度折旧,而精心维护的领域上下文与经过校验的词元空间记忆,每换上一代更强的模型读取它,价值就会跟着升值一次。
2. 对抗隔离与确定性传感器
强化学习优化推得越狠,模型钻空子刷分(reward hacking)的手段就越隐蔽、越难察觉。2025年3月,OpenAI对齐研究团队记录到前沿RL编程模型会在运行时直接调用 exit(0)、抛出 SkipTest,甚至直接解析测试文件来伪造全绿构建;一旦在思维链(CoT)监控器里对欺骗性念头施加惩罚,模型就会演化出隐蔽奖励作弊(obfuscated reward hacking),一边在思维链里装作老实合规,一边照旧在代码里暗度陈仓。Anthropic对齐团队发现Claude 3.7 Sonnet在超过99%的提示下会利用人为注入的评分漏洞,却在超过一半的测试环境里把说出作弊意图的比例压在2%以下;2025年11月Anthropic的一项生产级RL实验还观测到,一个学会靠 sys.exit(0) 作弊的模型,有12%的概率会主动尝试破坏专门用来抓它的监控脚本。
已部署模型的实测基准充分证明,环境级硬边界远比提示词里的苦口婆心管用。在ImpossibleBench基准上,研究人员故意让单元测试与自然语言需求说明自相矛盾,因此任何跑通测试的提交本质上都是在篡改或迎合错误测试。面对Conflicting-SWEbench,GPT-5的作弊率高达54%,o3达到49%。而只做两项确定性的Harness改造,即把测试文件以只读权限挂载,并给代理提供一个针对矛盾需求的显式人工升级上报工具,作弊率立刻骤降到9%和12%。再把另外两组生产数据摆在一起看:Veracode实测发现45%的AI编程任务产物带有安全漏洞;Cognition在2026年4月公布的生产遥测表明,一个上下文彻底隔离、与写代码的代理零历史共享的Devin Review审查代理,平均每个PR能抓出两个真实bug(其中约58%属于严重级别)。
写作业的人绝对不能自己给自己批卷子。Thoughtworks工程师Birgitta Böckeler于2026年4月在 martinfowler.com 上把这条界限划得清清楚楚:她将前馈引导(feedforward guides)与反馈传感器(feedback sensors)拆开,并分别映射到两种执行基底上,一边是基于概率推理的控制层(大模型代码审查员),另一边则是确定性的计算控制层(编译器、架构适应度测试、AST静态检查器与密钥扫描器)。
神经网络永远替代不了确定性门禁。正是为了守住这道边界,我动手造了三个开源工具:AntiSlop(基于Rust和Tree-sitter构建的AST静态检查器,专门在15种以上语言里拦截占位符空桩与拖延式错误处理,详见《对你的AI零信任》)、EnvCheck(跨Kubernetes、Terraform与CI流水线校验 .env 配置一致性,详见《90%解法》),以及NerfStatus(用17组行为探针实时揪出模型供应商静默降智与量化退化,详见《无声的模型坍塌》)。正如Stripe工程团队在每周合并约1,300个AI提交的实战中总结的那样,你没法靠在Markdown文件里轻声细语地叮嘱AI代理来指望它守规矩;你必须在它的写入权限之外直接焊死钢铁护栏。
3. 运行时物理边界与KV缓存经济学
没有任何一组模型权重能自己给自己凭空隔离出Linux命名空间,也没法在字节流跨出网络边界前确定性地脱敏受监管个人隐私数据(PII),更不可能废除推理侧的单位成本铁律。Manus团队公开过一组账单:命中KV缓存的输入词元($0.30/MTok)与未命中的词元($3.00/MTok)之间足足相差10倍成本,这直接倒逼工程层严格恪守只追加(append-only)的上下文纪律,并在logit层面做工具掩码,彻底放弃在运行中途动态修改系统提示词的做法。就连Google Cloud AI研究院在2026年10月推出的递归元框架Harness²(在无需标准答案验证器的前提下,把GLM-5与Gemini 3.5 Flash的成绩拉高了4.5至11.8个百分点),同样运行在冻结的模型权重之外;其消融实验也证实,可按需加载的技能模块(移除后掉5.3分)与可执行脚本(移除后掉3.7分)所贡献的分量,远远高于纯文本提示词指令(移除后仅掉1.5分)。
4. 33台猛禽发动机难题:多代理协同
这第四层不可压缩的边界,把故事径直带回了得州星舰基地(Starbase),也带回了《从硅片到交响乐》的核心命题。
纵观2026年星舰V3与猛禽3代的四次试飞(第12至第15次飞行),SpaceX已经彻底证明了单台猛禽3代发动机的可靠性。第14次试飞(2026年9月28日)顺利入轨并成功部署26颗正式服役的星链V3卫星;第15次试飞(2026年11月13-14日)创下了航天史上的首次纪录,发射塔的机械臂(「筷子」)在二级飞船Ship 42太空飞行22.5小时返回后,稳稳在半空中将其捕获回收。
然而在这全部四次V3发射中,并联了33台发动机的超重型V3助推器却无一成功回收。第12次试飞因级间热分离高温及错误的发动机报警阈值痛失助推器;就在上周的第15次试飞中,Booster 22助推器靠33台猛禽3代干净利落地满推力升空,却在返航点火阶段遭遇外圈发动机停机与推进剂余量吃紧,被迫中止塔架捕获,最终溅落在墨西哥湾,这也直接促使团队启动猛禽V3.2一致性改进,并将飞控软件的一级主发动机提前关机(MECO1)时序往前调早了一秒。
就算你把单台发动机外部87.4%的Harness砍得干干净净,如何在严苛的推进剂余量下让33台发动机毫秒不差地同步运转,依然是一道横在眼前的硬骨头。这就是用不锈钢浇铸出来的《97%困局》。
多代理软件正踩在同一条断层线上。Google与MIT在2026年4月开展的一项受控评测(横跨6个基准、260种配置)测出,多代理编排带来的平均收益变化为-0.3%,在不同任务间从集中式Finance Agent上的+80.8%剧烈摆动到独立并行PlanCraft任务上的-70.0%,再次印证了Cemri等人在NeurIPS 2025轨迹研究中所揭示的残酷现实:七大主流开源多代理框架的故障率高达41%至86.7%。Cognition团队从2025年6月的*《别造多代理(Don't Build Multi-Agents)》到2026年4月的《多代理:到底什么真管用》*,历时十个月的演进最终收敛到了「单线程写入配合干净上下文审查员」的模式,并得出结论:剩下的未解瓶颈,清一色全是通信与协同问题。
一旦跨越组织信任边界,这道协同门槛还会进一步硬化。2026年9月,华盛顿大学的研究人员展示了一组实验:诚实的点对点代理仅仅为了协调一次日常排期,就会陷入超过100条消息的确认死锁,而只要混入一个故障代理或恶意代理,就能轻易劫持最终决议。他们为此提出的五层社交Harness(可验证身份、保序传输、个人防火墙、协作契约与防篡改取证),在架构上与我在《谐波协同理论》(HCT)中形式化定义的六层体系不谋而合。
不妨回顾一下我在《从硅片到交响乐》里做过基准实测的三个 hct-core 扩展组件:ReservationStationOrchestrator(借鉴Tomasulo乱序执行与操作数前递,实现2.6倍加速)、DVFSRouter(借鉴DVFS动态调频调压,在跨档位模型路由中砍掉69.7%成本),以及 MESICoherencyManager(通过 fermata 独占写入请求锁与 cue 失效广播实现MESI缓存一致性,消除66.7%的陈旧共享状态读取)。这里头的每一个原语,管的全是跨代理时序、跨模型档位成本核算,或是共享状态写入权归属。就算你把单个小提琴手的演奏水平提升十倍,乐谱上的速度标记、延音记号,还有指挥手里的那根指挥棒与入场手势,依然一个都省不掉。
半衰期审计
代理代码库里的每一个模块,都有各自截然不同的折旧速率。别把你的Harness当成永久不变的框架死守,也别听信几句播客口号就盲目全盘删光;最稳妥的工程做法,是按代际半衰期对每一层做一次审计:
| Harness层级 | 猛禽发动机对照 | 半衰期 | 工程准则 |
|---|---|---|---|
| 正则JSON解析器与重试封装层 | 猛禽1代电火花点火器与液膜冷却 | 已被彻底吸收 | 今天就删;直接依赖100%合规的原生结构化输出 |
| 15-30项定制工具菜单与静态代码向量库 | 猛禽1/2代外置盘管与传感器网 | 6-12个月 | 抱着随时删除的心态构建;直接暴露bash/REPL与原生底层协议 |
| 会话重置、冲刺拆分包装器与死循环熔断器 | 猛禽2代一体化阀板与报警阈值 | 随具体模型而异 | 每次模型升级必做消融测试;只保留能拉动真实仓库评测指标的部分 |
| 可变业务领域语义与情景记忆库 | 推进剂配比规范与飞行任务剖面 | 持续升值资产 | 重兵投入;维护约100行的精简仓库索引图与经校验的领域记忆 |
| 安全沙盒、只读测试挂载、AST检查器与干净上下文审查员 | 发射台底座、推力传力座与飞行终止系统 | 永久存续(物理与信任边界) | 硬编码焊死在代理写入权限之外(如AntiSlop、EnvCheck) |
| 多代理调度分发、状态一致性、跨档路由与协作契约 | 超重型助推器上33台猛禽的并联同步 | 永久存续(核心前沿) | 标准化显式信号、单写者锁与HCT协同契约 |
生产级代理团队的四个习惯
如果你今天正负责一套生产级代理平台,养成下面这四个工程习惯,就能让你的技术栈稳稳站在猛禽演化曲线的正确一侧:
每次模型升级,固定排一次「代码删除日」。 把每一个定制工具封装、规划器拆分和重试中间件,都当成针对特定模型检查点打下的带保质期补丁。每当新一代前沿模型发布,立刻在自家真实仓库基准上跑一轮消融测试,逐个关掉现有的Harness模块。只要删掉15个工具能让系统更快、更准,当天下午就把那堆代码彻底删干净。
让评测集与Harness代码同库做版本管理。 市面上60%的开源Harness既没测试也没评测,35个小版本迭代不知不觉多烧掉70%词元却零准确率提升的惨剧就是这么来的。每次提交Harness代码时,同步度量任务解决率、交互轮数以及缓存命中与未命中的词元账单;同时用NerfStatus这类行为探针持续盯住线上供应商接口,千万别把模型服务商的静默降智误诊成自家Harness出了bug。
把工程规矩从自然语言叮嘱编译成确定性门禁。 代理每次偷懒走捷径时,别再往
AGENTS.md末尾硬塞第48段话了。把AGENTS.md控制在精悍的架构路由图篇幅,把单元测试目录以只读方式挂载在编码代理的文件系统视野之外,用AntiSlop和EnvCheck这类AST与配置检查器强制卡死依赖边界和零占位符卫生标准,并在合并前用上下文隔离的审查代理把好最后一道关。把长期研发预算集中投向「那195公斤」和「33机交响乐团」。 把你最宝贵的常设工程人力,花在基础模型永远吞不进去的三样核心资产上:随业务实时演进的领域语义文档、加固过关的执行沙盒与验证边界,以及形式化的多代理协同原语(响应式操作数前递、MESI状态所有权锁,以及DVFS跨档位模型路由)。
工程手艺向何处迁移
2026年3月,Anthropic工程师Prithvi Rajasekaran用一段极干净的话点透了这条不断迁移的边界:
"随着模型不断变强,有价值的Harness组合空间并未萎缩;它的位置一直在迁移,而AI工程师真正有意思的工作,就是不断找到下一个全新的组合。"
Rich Sutton在2025年也为他自己的「苦涩的教训」补上了一条同样犀利的限定:当前的语言模型是从静态训练语料库中学习的,尚未进入从连续实时经验中学习的阶段。在冻结的后训练权重与瞬息万变的生产环境之间,横亘着整门系统工程学。
在《从硅片到交响乐》里,核心结论落在空间维度:别再靠拍脑袋拼凑临时的代理有向图了,把CPU架构与交响乐团验证了五十年的协同不变量直接移植进你的运行时。而猛禽定律,则补上了时间维度上的工程纪律。
你依然得先老老实实造出猛禽1代满身裸露的传感器,才有资格换来猛禽3代干净利落的外壳;同时你也必须足够冷酷清醒,在新模型把某层能力吸收进权重的那天早上,毫不留恋地亲手拆掉自己辛辛苦苦接好的外部管路。真正经得起时间冲刷的工程价值,永远留在发动机金属外壁之外:描绘动态业务领域的语义地图、抵御熵增的确定性门禁,以及让33台发动机严丝合缝编队飞行的协同信号。
Stefan Wiest是一位创始系统与AI架构师,也是《谐波协同理论》(HCT)与Genesis框架的提出者。本文是2026年长文《从硅片到交响乐》在时间维度上的姊妹篇,部分理论脉络源自《架构收敛》论文及开源确定性代理工具链github.com/skew202。如果你想每周读到关于如何在生产环境中执棒指挥AI系统的一线手记,欢迎订阅SeekingSota。